クローラー・インデックスとは?サイトがGoogleに認識される仕組み
以前の記事(「検索エンジンとは?Googleがサイトを見つけて順位を決める仕組み」)で、検索エンジンが「クロール→インデックス登録→ランキング」という3段階で動いていることを解説しました。
この記事では、その最初の2段階である「クローラー」と「インデックス」について、実際に自分のサイトの状態を確認する方法まで踏み込んで解説します。
おさらい:クローラーとインデックスの役割
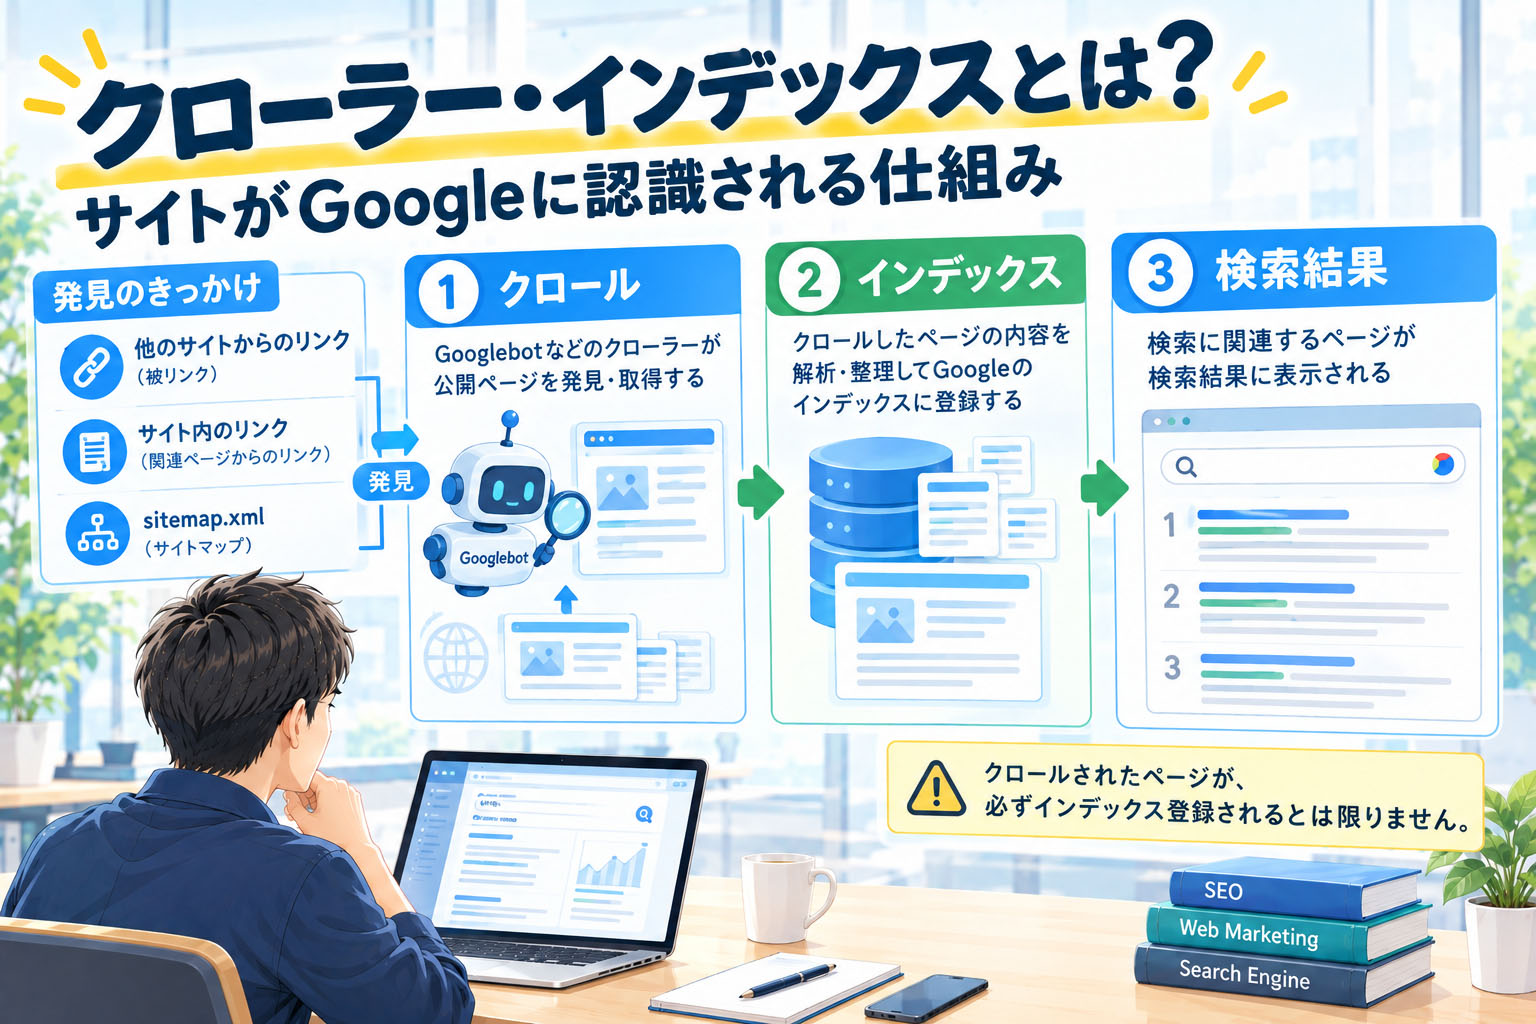
クローラー(Googlebot)は、Web上のページを巡回して発見する仕組み、インデックスは、発見したページの内容を分析してデータベースに登録する仕組みです。
自分のホームページが検索結果に表示されるためには、まずクロールされ、次にインデックス登録される必要があり、どちらか一方が欠けても、検索結果には表示されません。
ここからは、この2つの段階を、自分のサイトについて実際に確認したり、コントロールしたりする方法を解説します。
自分のサイトがインデックスされているかを確認する方法
自分のホームページが、実際にGoogleにインデックス登録されているかどうかは、Googleが無料で提供している「Google Search Console」というツールで確認できます。
Search Consoleの「URL検査」ツールにURLを入力すると、そのページがGoogleに登録されているかどうか、登録されていない場合はその理由を確認できます。
まだ登録されていないページについては、URL検査ツールの画面から「インデックス登録をリクエスト」を行うことで、優先的にクロールしてもらうよう依頼することができます。
新しく公開したページや、内容を大きく更新したページについては、公開直後にこのリクエストを行うと、サイトマップ経由で発見されるのを待つよりも早くクロールされる傾向があります。
サイトマップ:サイトの中身をまとめてGoogleに伝える
サイトマップとは、サイト内に存在するページの一覧を、Googleに伝えるためのファイルです。
Search Consoleの「サイトマップ」メニューから、サイトマップのURL(多くの場合「sitemap.xml」)を送信しておくことで、Googleがサイト内のページを効率よく発見できるようになります。
サイトマップの送信は、クロールを保証するものではなく、あくまでクローラーに手がかりを与えるための機能です。
WordPressの場合、SEO系のプラグインの多くが、サイトマップを自動生成する機能を備えています。
robots.txtとnoindex:似ているようで役割が違う2つの設定
クロールとインデックス登録を、あえて「されないように」制御したい場面もあります。
このとき使われるのが「robots.txt」と「noindexタグ」で、この2つは役割が異なります。
robots.txtは、クローラーがページを訪問する前の段階で確認するファイルで、指定したページやディレクトリへのクロールそのものをブロックします。
noindexタグは、ページの内に記述するタグ(または応答ヘッダー)で、クロール自体は許可したうえで、インデックス登録だけをブロックします。
ここで注意が必要なのは、この2つを同時に使ってはいけないという点です。
Google検索セントラルの公式ドキュメントには、「Googlebotがページをクロールできるようにする必要がある。robots.txtファイルでページがブロックされている場合、またはクローラがページにアクセスできない場合、Googlebotはnoindexルールを認識しない」と明記されています。
つまり、robots.txtでクロールをブロックしたページにnoindexを設定しても、Googlebotはそのページを訪問できないため、noindexタグの存在に気づくことができず、結果として意図に反してインデックス登録されたままになる可能性があります。
特定のページを検索結果から確実に外したい場合は、robots.txtでブロックするのではなく、noindexタグを使うのが正しい方法です。
おわりに
クローラーとインデックスの仕組みを理解しておくと、自分のホームページが検索結果に表示されない場合に、どこに原因があるのかを切り分けやすくなります。
Search Consoleでインデックス状況を確認し、サイトマップを送信し、robots.txtとnoindexを正しく使い分けることが、基本的な管理方法です。
次の記事では、外部対策の中心的な要素である「被リンク」について解説します。
参考にした情報
- ページ インデックス登録レポート(Search Console ヘルプ) https://support.google.com/webmasters/answer/7440203?hl=ja
- noindexを使用してインデックス登録をブロックする(Google検索セントラル) https://developers.google.com/search/docs/crawling-indexing/block-indexing?hl=ja